Software-Testmetriken und KPIs: Vollständiger Leitfaden zu QA-Metriken
TL;DR: QA-Testmetriken messen die Softwarequalität, Testeffizienz und Teamproduktivität. Dieser Leitfaden behandelt die Metriken, die wirklich wichtig sind: Testabdeckung, Fehlererkennungsraten, MTTD, MTTR sowie die Formeln und Frameworks, die Sie benötigen, um Metriken auszuwählen, die Ihre Testergebnisse verbessern und Ihnen helfen, bessere Software schneller auszuliefern.
QA-Testmetriken unterscheiden effektive Testprogramme von solchen, die blindlings durchgeführt werden. Die meisten QA-Teams verfolgen zu viele oder völlig falsche Metriken. Am Ende haben Sie Dashboards voller Zahlen, die Ihnen nicht sagen, ob Ihre Teststrategie funktioniert, wo Ihre Engpässe liegen oder ob Sie bereit für die Auslieferung sind.
Die wichtigen Kennzahlen beantworten konkrete Fragen: Testen die Teams die richtigen Dinge? Wie schnell können sie Probleme erkennen und beheben? Werden Fehler entdeckt, bevor Kunden sie finden? Dieser Leitfaden behandelt die QA-Kennzahlen, die diese Fragen beantworten, Testprozesse verbessern und zu besseren Release-Entscheidungen beitragen.
Was sind QA-Metriken beim Testen von Software? (Definition und Beispiele)
QA-Metriken sind Messwerte, die Ihnen Aufschluss darüber geben, wie gut Ihre Tests funktionieren. Sie erfassen alles von der Testabdeckung und Fehlerquote bis hin zur Testdauer und den Testkosten. Die Messwerte selbst stammen aus Ihrem Testmanagementsystem, Ihrem Bug-Tracker und Ihrer CI/CD-Pipeline.
Gute QA-Kennzahlen beantworten echte Fragen zu Ihren Testvorgängen:
- Was wurde getestet und wie gründlich?
- Wie lange wird es dauern, diese Version zu testen?
- Werden die Tests bis zum Stichtag abgeschlossen sein?
- Wie schwerwiegend sind die gefundenen Fehler?
- Wo liegen die Engpässe, die den Prozess verlangsamen?
- Wie viel kostet das Testen?
In der Qualitätssicherung kann man fast alles messen, und die meisten Teams verfolgen am Ende mehr als 20 Kennzahlen und versinken in Daten. Es ist effizienter, 5 bis 10 Kennzahlen auszuwählen, die direkt Ihre wichtigsten Fragen beantworten.
Warum QA-Metriken wichtig sind: Wie Metriken die Softwarequalität und die Release-Bereitschaft verbessern
Was Sie nicht messen, können Sie auch nicht verbessern. QA-Kennzahlen zeigen Ihnen, ob Ihre Teststrategie funktioniert und wo sie noch verbesserungswürdig ist. Ohne Kennzahlen können Sie nur Vermutungen über die Testabdeckung, die Schwere von Fehlern und die Versandbereitschaft anstellen.
Teams, die die richtigen Kennzahlen verfolgen:
- Erkennen Sie Muster, wo sich Fehler häufen, und konzentrieren Sie sich dort auf Tests.
- Prognostizieren Sie, wie lange das Testen für ähnliche Releases dauern wird.
- Qualitätsprobleme frühzeitig erkennen, anstatt sie erst in der Produktion zu entdecken
- Rechtfertigen Sie das QA-Budget und die Personalstärke mit konkreten ROI-Daten.
- Entscheidungen zur Veröffentlichung auf der Grundlage von Daten statt Bauchgefühl treffen
Teams, die hochwertige Software liefern, messen, was wichtig ist. Alles zu messen hilft nicht weiter – Sie brauchen Kennzahlen, die Ihnen Entscheidungen erleichtern.
Arten von QA-Kennzahlen und KPIs: Absolute, abgeleitete, vorlaufende und nachlaufende Indikatoren
QA-Kennzahlen lassen sich in einige nützliche Kategorien einteilen.
Absolute vs. abgeleitete QA-Metriken (und wann welche zu verwenden sind)
Absolute Kennzahlen sind Werte, die Sie direkt messen: Anzahl der durchgeführten Tests, Anzahl der gefundenen Fehler, für das Testen aufgewendete Stunden. Sie sind leicht zu verfolgen, aber es fehlt ihnen der Kontext.
Abgeleitete Metriken kombinieren zwei oder mehr Messungen, um Ihnen diesen Kontext zu vermitteln. Die Test-Erfolgsquote (bestehende Tests geteilt durch die Gesamtzahl der Tests) sagt mehr aus als nur die Information, dass Sie 500 Tests durchgeführt haben. Die Fehlerdichte (Fehler pro 1.000 Zeilen Code) sagt mehr aus als die reine Anzahl der Fehler.
Die nützlichsten Kennzahlen werden abgeleitet, da sie die Größenordnung berücksichtigen und Vergleichspunkte liefern.
Testeffektivität vs. Effizienz des QA-Teams
Einige Kennzahlen messen, ob Ihre Tests Fehler effektiv erkennen. Andere messen, ob Ihr Team Tests effizient durchführt. Beide sind wichtig, beantworten jedoch unterschiedliche Fragen.
- Testwirksamkeit: Spiegelt der Test die Produktqualität genau wider? Werden die wichtigen Fehler erkannt?
- Teameffizienz: Werden Tests pünktlich ausgeführt? Werden die Testzeiten sinnvoll genutzt?
Teams konzentrieren sich oft zu sehr auf Effizienzkennzahlen (durchgeführte Tests pro Tag, pro Tester protokollierte Fehler) und zu wenig auf Effektivitätskennzahlen (wie viel Prozent der Produktionsfehler blieben während des Testens unentdeckt).
Vorlaufende vs. nachlaufende Indikatoren
Frühindikatoren (Testabdeckung, Testausführungsstatus) liefern Informationen für Entscheidungen während des Testens. Sie zeigen, ob Sie auf dem richtigen Weg sind, garantieren jedoch keine qualitativ hochwertigen Ergebnisse.
Nachträgliche Indikatoren (in der Produktion gefundene Fehler, Kundenbeschwerden) geben Ihnen definitiv Auskunft darüber, ob Sie qualitativ hochwertige Software ausgeliefert haben. Diese Daten erhalten Sie erst nach der Veröffentlichung, wenn die Behebung von Problemen mehr kostet.
Sie benötigen beides. Frühindikatoren dienen als Orientierungshilfe für Release-Entscheidungen. Spätindikatoren bestätigen, ob diese Entscheidungen richtig waren, und liefern Informationen für Ihren nächsten Release-Zyklus.
Die Diskrepanz zwischen den Prognosen der Frühindikatoren und den Ergebnissen der Spätindikatoren sagt am meisten über Ihren Testprozess aus.
Wie man QA-Metriken auswählt: Ein Rahmenkonzept für die Auswahl der richtigen Test-KPIs
Beginnen Sie damit, Ihre größten Qualitätsprobleme oder Fragen zu identifizieren: Kennzahlen dienen dazu, Fragen zu beantworten und Entscheidungen zu treffen, nicht dazu, Dashboards zu füllen.
Drei Kriterien bestimmen, ob eine Kennzahl es wert ist, verfolgt zu werden:
- Können Sie darauf reagieren? Wenn eine Kennzahl steigt oder sinkt, wissen Sie dann, was Sie ändern müssen? Kennzahlen, die keine Maßnahmen nach sich ziehen, sind Zeitverschwendung.
- Können Sie diese regelmäßig aktualisieren? Metriken, die Sie nur vierteljährlich berechnen, helfen bei der Sprintplanung nicht weiter. Passen Sie die Häufigkeit der Metriken an die Häufigkeit der Entscheidungen an.
- Entspricht dies Ihren Zielen? Wenn Ihr Ziel schnellere Releases sind, sollten Sie Kennzahlen verfolgen, die sowohl Geschwindigkeit als auch Qualität messen, nicht nur Geschwindigkeit.
Die meisten Teams sollten maximal 5 bis 10 Kernkennzahlen verfolgen. Bei mehr als dieser Anzahl verbringen Sie mehr Zeit mit der Analyse von Daten als mit der Verbesserung der Tests.
Grenzen Sie es ein:
Passen Sie die Metriken an Ihren Testansatz an
Manuelle Testteams benötigen andere Kennzahlen als Teams, die stark auf Automatisierung setzen. Manuelle Tests decken andere Muster auf: Probleme mit der Benutzerfreundlichkeit, Randfälle, Probleme mit dem Workflow. Die Automatisierung eignet sich hervorragend, um Regressionen und Konsistenzprobleme zu erkennen. Wenn Sie hauptsächlich manuelle Tests durchführen, konzentrieren Sie sich auf die Fehlererkennungsrate und die Testausführungszeit. Wenn Sie stark automatisiert arbeiten, verfolgen Sie die Teststabilität, die Ausführungszeit und die Trends bei der Erfolgsquote.
Passen Sie die Metriken an Ihre Entwicklungsmethodik an.
Wasserfall-Teams müssen einen stärkeren Fokus auf Regressions- und Abdeckungsmetriken legen, da alle Tests vor der Veröffentlichung durchgeführt werden. Agile Teams profitieren mehr von Metriken auf Sprint-Ebene wie ungelösten Fehlern und Produktionsausfällen, da Sie kontinuierlich liefern.
Aktivitäten und Ergebniskennzahlen ausgleichen
Durchgeführte Tests und protokollierte Fehler zeigen, dass das Team arbeitet. Die Fehlerausfallrate und von Kunden gemeldete Probleme zeigen, ob die Arbeit von Bedeutung ist. Verwechseln Sie Aktivität nicht mit Ergebnissen.
Vermeiden Sie eine Überlastung mit Metriken
Zwanzig Kennzahlen bedeuten, dass Sie alles verfolgen und nichts verbessern. Wählen Sie die 5 bis 10 Kennzahlen aus, die Ihre wichtigsten Fragen beantworten – Sie können später bei Bedarf jederzeit weitere hinzufügen.
Metriken auf die Organisationsebene zuschneiden
Projektmanager verfolgen die tägliche Ausführung, wie Testfortschritt, Fehleranzahl und Sprintgeschwindigkeit. Abteilungsleiter verfolgen umfassendere Muster, wie MTTD, MTTR und Qualitätstrends über Projekte hinweg. Führungskräfte verfolgen die Auswirkungen auf das Geschäft, wie Fehlerausfallraten, Test-ROI und Qualitätskosten.
Wichtige QA-Kennzahlen und KPIs, die für bessere Testergebnisse zu verfolgen sind
Diese Kennzahlen bieten durchweg einen Mehrwert für verschiedene Teams und Methoden. Nicht jede Kennzahl ist für Ihre Situation relevant; die meisten Teams wählen aus dieser Liste ihre 5 bis 10 wichtigsten Kennzahlen aus.
Testabdeckungsmetriken (Ausführungs-, Funktions- und Risikoabdeckung)
Testabdeckung
Die Testabdeckung gibt Auskunft darüber, wie viel Ihrer Anwendung Sie tatsächlich testen. Ohne Abdeckungsmetriken wissen Sie nicht, ob Sie Lücken haben.
Testfallmanagementsysteme visualisieren die Abdeckung und zeigen Ihnen, wo Lücken bestehen. Das Ziel besteht darin, jede Anforderung mindestens einem Test zuzuordnen.
Fortschritt der Testdurchführung
Der Testausführungsfortschritt verfolgt ausgeführte Tests im Vergleich zu ausstehenden Tests. Er beantwortet die Frage „Liegen wir im Zeitplan?“ während der Testausführung.
Testausführungsabdeckung = (ausgeführte Testfälle / geplante Testfälle) × 100
Funktionale Abdeckung
Die funktionale Abdeckung misst, ob Ihre Tests alle Produktfunktionen abdecken. Sie führen Ihren Testplan zu 100 % aus, haben aber dennoch funktionale Lücken, wenn Ihr Testplan nicht alles abdeckt.
Berechnen Sie dies, indem Sie die getesteten Funktionen durch die Gesamtzahl der Funktionen in der Anwendung dividieren. Diese Unterscheidung ist wichtig, da Teams häufig den Fortschritt der Testausführung mit der tatsächlichen Abdeckung verwechseln. Es kann vorkommen, dass Sie alle geplanten Tests ausführen und dennoch ganze Funktionsbereiche, Integrationspunkte oder workflows übersehen.
Risikoabdeckung
Risikoabdeckung gewichtet Tests nach Risikostufe. Nicht alle Tests sind gleich wichtig. Tests, die die Zahlungsabwicklung, Datensicherheit oder compliance gesetzlicher compliance abdecken, compliance mehr Aufmerksamkeit als kosmetische UI-Tests.
Bei einer Medizinprodukteanwendung, die Daten aus APIs von Drittanbietern abruft, stellt die Risikodeckung sicher, dass Sie testen, was passiert, wenn diese API ausfällt. Stürzt Ihre App ab, zeigt sie eine Fehlermeldung an, verwendet sie zwischengespeicherte Daten oder wechselt sie zu einer Backup-Quelle? Die Risikodeckung stellt sicher, dass kritische Szenarien getestet werden.
Um die Risikodeckung zu bewerten, sollten Sie Folgendes verfolgen:
- Abdeckung der Risiken mit höchster Priorität
- Ob Risikogebiete Ihren Qualitätsansprüchen genügen
- Prozentualer Anteil der nicht getesteten Risikoszenarien
Defekte pro Anforderung
Fehler pro Anforderung zeigen, welche Funktionen problematisch sind. Eine Anforderung, die 15 Fehler verursacht, während andere Anforderungen durchschnittlich 2-3 Fehler verursachen, deutet auf Probleme hin: unklare Anforderungen, technische Komplexität oder unzureichende Designarbeit. Sie identifizieren Funktionen, die vor der Veröffentlichung mehr Aufmerksamkeit erfordern.
Regressionstest-Metriken: Messung der Auswirkungen von Änderungen und der Testwirksamkeit
Jede Codeänderung birgt das Risiko, dass bestehende Funktionen beeinträchtigt werden. Regressionsmetriken quantifizieren dieses Risiko.
Fehlerspritzrate
Die Fehlerinjektionsrate misst die Anzahl der pro Codeänderung eingeführten Fehler. Berechnen Sie sie, indem Sie die getesteten Änderungen durch die zuordenbaren Fehler dividieren.
Wenn Sie 10 Änderungen vornehmen und dabei 30 Fehler finden, beträgt Ihre Fehlerinjektionsrate 3 Fehler pro Änderung. Hohe Injektionsraten bedeuten, dass Code-Reviews verstärkt werden müssen, Entwickler bessere lokale Tests durchführen müssen oder dass architektonische Entscheidungen zu fehleranfälligen Änderungen führen.
Auswirkungen von Teständerungen
Die Auswirkungen von Tests lassen sich anhand von Fehlern, die auf Codeänderungen zurückzuführen sind, und solchen, die andere Ursachen haben, unterscheiden. Dazu müssen Fehler nach ihrer Ursache kategorisiert werden, was zwar aufwendig ist, aber wertvolle Erkenntnisse darüber liefert, wo Qualitätsprobleme ihren Ursprung haben.
Teams, die dies verfolgen, unterscheiden zwischen „unsere neue Funktion hat Fehler“, „unsere Fehlerbehebung hat etwas anderes beschädigt“ und „dies war schon immer defekt, aber niemand hat es bemerkt“. Jedes Muster weist auf unterschiedliche Ursachen hin. Fehler in neuen Funktionen deuten auf unzureichendes Design oder unklare Anforderungen hin. Regressionsfehler weisen auf unzureichende Testabdeckung oder eine instabile Architektur hin. Latente Fehler, die erst spät auftreten, deuten oft auf Lücken in der explorativen Prüfung oder der Abdeckung von Randfällen hin.
Metriken für das Testteam
Diese Kennzahlen erfassen die Arbeitsbelastung und Produktivität des Teams. Sie dienen als Grundlage für die Ressourcenplanung und identifizieren Teammitglieder, die Unterstützung benötigen.
Gemeldete und zurückgewiesene Mängel
Gemeldete Fehler und abgelehnte Maßnahmen sowohl hinsichtlich Umfang als auch Qualität. Ein Tester, der 50 Fehler protokolliert, aber 30 abgelehnt bekommt (Duplikate, nicht reproduzierbar, funktioniert wie vorgesehen), benötigt klarere Akzeptanzkriterien, bessere Testumgebungen oder gründlichere Untersuchungen vor der Protokollierung von Fehlern.
Vergleichen Sie dies zwischen den Teammitgliedern, um Muster zu erkennen. Eine hohe Anzahl von reporting mit geringer Qualität reporting die Entwickler Zeit. Eine geringe Anzahl kann auf unzureichende Tests oder übersehene Probleme hindeuten.
Pro Teammitglied zugewiesene/ausgeführte Testfälle
Die pro Teammitglied zugewiesenen Testfälle und die pro Teammitglied ausgeführten Testfälle geben Aufschluss über die Verteilung der Arbeitslast. Nutzen Sie diese Informationen, um eine ausgewogene Aufgabenverteilung sicherzustellen und Engpässe zu identifizieren. Wenn ein Tester ständig hinterherhinkt, ist er möglicherweise blockiert, überlastet oder benötigt zusätzliche Unterstützung.
Testaufwand-Metriken
Diese Kennzahlen beantworten die Fragen „Wie lange dauert das Testen?“ und „Werden wir schneller oder langsamer?“
Pro Zeitraum abgeschlossene Tests
Pro Zeitraum durchgeführte Tests = Durchgeführte Tests / Aufgewendete Zeit. Damit werden Basiswerte für die Schätzung festgelegt. Wenn Ihr Team durchschnittlich 50 Tests pro Tag durchführt, dauert die Durchführung von 500 Tests 10 Tage.
Effizienz des Testdesigns
Effizienz des Testdesigns = Entworfene Tests / Für das Design aufgewendete Zeit. Verfolgen Sie dies getrennt von der Ausführung, da Design und Ausführung unterschiedliche Engpässe aufweisen. Eine sinkende Designeffizienz deutet oft auf zunehmend komplexe Funktionen oder schlecht spezifizierte Anforderungen hin.
Fehlerfindungsrate
Fehlerfindungsrate = Gesamtzahl der Fehler / Gesamtzahl der Tests. Dies zeigt Ihnen die Fehlerdichte. Wenn die Rate nach mehreren Testzyklen hoch bleibt, finden Sie immer noch neue Probleme. Wenn sie gegen Null sinkt, nähern Sie sich sinkenden Erträgen.
Durchschnittliche Zeit zum Testen einer Fehlerbehebung
Durchschnittliche Zeit für das Testen einer Fehlerbehebung = Gesamtzeit für erneute Tests / Gesamtzahl der Fehlerbehebungen. Teams mit langen Wiederholungszeiten verfügen oft nicht über gute Reproduktionsschritte, haben eine schlechte Kommunikation zwischen Entwicklern und Testern oder testen in instabilen Umgebungen.
Fehlerverteilungsmetriken
Die Verfolgung der Häufung von Fehlern zeigt Ihnen, wo sich Qualitätsprobleme konzentrieren.
Grafische Darstellung von Fehlern nach Schweregrad, Komponente, Testtyp oder Ursache. Dabei lassen sich Muster erkennen. Wenn 60 % der Fehler aus einem Modul stammen, muss dieses Modul einer architektonischen Überprüfung oder zusätzlichen Tests unterzogen werden. Wenn die meisten kritischen Fehler bei manuellen Tests gefunden werden, die meisten kleineren Fehler jedoch aus der Automatisierung stammen, sind Ihre Ressourcen richtig verteilt.
Die Fehlerverteilung entwickelt sich weiter. Zu Beginn eines Projekts finden Sie eher Architektur- und Integrationsfehler. Gegen Ende eines Projekts finden Sie eher Randfälle und Probleme mit der Benutzerfreundlichkeit. Verfolgen Sie die Verteilung im Laufe der Zeit, um sicherzustellen, dass Sie sich gemäß den erwarteten Mustern weiterentwickeln.
Fehlererkennungskennzahlen (MTTD, MTTR und Wiederherstellungsleistung)
Wie schnell Sie Fehler finden und beheben, bestimmt, wie viel sie kosten.
Mittlere Zeit bis zur Erkennung von Fehlern (MTTD)
Mittlere Zeit bis zur Erkennung von Fehlern (MTTD) = Zeitaufwand für die Fehlersuche / gefundene Fehler
Je schneller Sie Probleme erkennen, desto kostengünstiger lassen sie sich beheben. Untersuchungen von IBM haben ergeben, dass Fehler, die während der Entwurfsphase entdeckt werden, sechsmal weniger kosten als Fehler, die während der Entwicklung entdeckt werden, und hundertmal weniger als Fehler, die in der Produktion entdeckt werden.
Teams mit hoher MTTD verfügen oft nicht über eine ausreichende Testabdeckung, führen Tests nur selten durch oder haben einen schlechten Überblick über die Testergebnisse.
Durchschnittliche Zeit bis zur Lösung (MTTR)
Durchschnittliche Zeit bis zur Behebung (MTTR) = Zeitaufwand für die Behebung von Fehlern / Behebt Fehler
MTTR misst, wie schnell Ihr Team Fehler behebt. Ein hoher MTTR-Wert weist auf bestimmte Engpässe hin: unzureichende Debugging-Tools, unklare Fehlerberichte, die einen Hin- und Her-Austausch mit der Qualitätssicherung erfordern, komplexe Codebasen, bei denen sich Korrekturen auf mehrere Module auswirken, oder fehlende Dokumentationen, die den Wissenstransfer verlangsamen. Teams, die den MTTR reduzieren, investieren in der Regel in bessere Protokollierung und Überwachung, klarere reporting mit reproduzierbaren Schritten und entwicklerfreundliche Staging-Umgebungen, die der Produktion entsprechen.
Eine schnelle MTTD und MTTR bedeuten zusammen, dass Sie Probleme schnell erkennen und beheben können. Dadurch bleibt die Entwicklungsdynamik hoch und der Bug-Rückstand wird reduziert.
Testen von ROI-Kennzahlen: Kosten pro Fehlerbehebung, Kosten für das Nichttesten und Test-ROI
Diese Kennzahlen rechtfertigen Testinvestitionen und decken versteckte Kosten auf.
Kosten pro Fehlerbehebung
Kosten pro Fehlerbehebung = Zeitaufwand für die Fehlerbehebung × Stundensatz des Entwicklers
Ein Entwickler, der 20 Stunden damit verbringt, einen Fehler zu beheben, kostet bei einem Stundensatz von 50 Dollar 1.000 Dollar (zuzüglich der Zeit für erneute Tests). Der gleiche Fehler, der früher entdeckt worden wäre, hätte vielleicht nur 100 Dollar gekostet.
Verfolgen Sie dies über den gesamten Entwicklungslebenszyklus hinweg, um die Kostenunterschiede zu quantifizieren. Fehler, die bei Designprüfungen gefunden werden, kosten nur minimale Entwicklerzeit, da noch kein Code existiert. Fehler, die bei Unit-Tests entdeckt werden, kosten möglicherweise 1–2 Stunden. Fehler, die bei Integrationstests entdeckt werden, kosten aufgrund der Komplexität der Fehlerbehebung 5–10 Stunden. Produktionsfehler kosten mehr als 50 Stunden, wenn man Notfall-Triage, Hotfix-Entwicklung, Bereitstellungskoordination, Kundenkommunikation und Reputationsschäden mit einberechnet. Diese Multiplikatoren sprechen für Shift-Left-Tests und strengere Qualitätskontrollen.
Kosten der Nichtprüfung
Zu den Kosten, die durch das Unterlassen von Tests entstehen, gehören Nacharbeitskosten, verlorene Kunden, Supportaufwand und Reputationsschäden. Wenn Teams Tests auslassen, um Termine einzuhalten, stellen sie fest, dass die Kosten für das Unterlassen von Tests die Kosten für das Testen um ein Vielfaches übersteigen. Eine überstürzte Veröffentlichung spart vielleicht zwei Wochen Testzeit, verursacht aber monatelange Notfallkorrekturen, Supportanfragen und Entschuldigungen gegenüber Kunden.
Zeitplanabweichung
Zeitplanabweichung = Geplanter Zeitplan – Tatsächlicher Zeitplan
Eine konsequent vorzeitige Fertigstellung deutet auf eine Überschätzung, verbesserte Effizienz oder unzureichende Testabdeckung hin. Eine konsequent verspätete Fertigstellung deutet auf eine Unterschätzung, Scope Creep oder Ressourcenengpässe hin, die angegangen werden müssen.
Beide Muster müssen untersucht werden. Daten zu Abweichungen vom Zeitplan verbessern die Prognosen für die Zukunft.
die Anzahl der jedem Teammitglied zugewiesenen Testfälle
Wie der Name schon sagt, misst diese Kennzahl die Anzahl der Testfälle, die den einzelnen Mitgliedern des Testteams zugewiesen werden. Dies ist eine weitere Kennzahl, die den QA-Leitern hilft, die Arbeit zu verteilen und sicherzustellen, dass jedes Teammitglied die seinen Fähigkeiten entsprechende Menge an Arbeit hat.
Die Anzahl der von jedem Teammitglied ausgeführten Testfälle
Mit den ausgeführten Testfällen wird gemessen, wie viel Arbeit (die Anzahl der Tests) jedes Mitglied Ihres Teams erledigt. Ähnlich wie bei der obigen Metrik kann dies den Teamleitern helfen, zu verfolgen, wie viel Arbeit jedes Teammitglied erledigt.
Testaufwand
Mit Hilfe von Testaufwandsmetriken lässt sich ermitteln, wie viele Tests ein Produkt benötigt, wie lange es dauert, alle Tests durchzuführen, und wie lange es dauert, Fehler in Ihrem Produkt zu beheben. Diese Metriken sind besonders wichtig, weil sie dazu beitragen, Schwankungen beim Testen besser zu verstehen und Grundlinien für ähnliche zukünftige Testplanungsprojekte festzulegen. Der Testaufwand wird anhand verschiedener Metriken bewertet:
Anzahl der Tests in einem bestimmten Zeitrahmen
Diese Kennzahl gibt Aufschluss über die Anzahl der in einem bestimmten Zeitraum durchgeführten Tests. Dies hilft den Entwicklern bei der Planung künftiger Testzeiten. Die Anzahl der Tests pro Zeitraum kann ermittelt werden, indem die Anzahl der abgeschlossenen Tests durch die Gesamttestzeit geteilt wird.
Formel: Anzahl der Tests in einer bestimmten Zeitspanne = Anzahl der durchgeführten Tests/Gesamtzeit
Effizienz des Testdesigns
Mit dieser Metrik soll die Entwurfseffizienz des durchgeführten Tests bewertet werden. Die Effizienz des Testentwurfs misst, wie lange ein Team braucht, um einen Test für eine bestimmte Anforderung vollständig zu entwerfen. Um die durchschnittliche Zeit zu ermitteln, teilen Sie die Gesamtzahl der von Ihrem Team entworfenen Tests durch die Gesamtzeit, die für den Entwurf benötigt wurde.
Formel: Testentwurfseffizienz = Anzahl der entworfenen Tests / Gesamtzeit
Anzahl von Fehlern pro Test
Die Anzahl der Fehler pro Test, manchmal auch als Fehlerfindungsrate bezeichnet, misst die Anzahl der Fehler (oder Defekte), die in jeder Testphase gefunden werden. Um diese Kennzahl zu ermitteln, können Sie die Gesamtzahl der Fehler durch die Gesamtzahl der Tests dividieren.
Formel: Anzahl der Fehler pro Test = Gesamtzahl der Fehler / Gesamtzahl der Tests
Durchschnittliche Zeit zum Testen einer Fehlerbehebung
Diese QA-Kennzahl hilft zu verstehen, wie viel Zeit für das Testen einer Fehlerbehebung aufgewendet wurde. Sie können diesen Durchschnittswert ermitteln, indem Sie die Gesamtzahl der Fehlerbehebungen, die Ihr Team testet, durch die Gesamtzeit für das Testen von Fehlerbehebungen teilen. Andere Metriken in der Testaufwandsgruppe umfassen Fehler pro Teststunde, die Anzahl der durchgeführten Tests und die durchschnittliche Zeit für das Testen einer Fehlerbehebung.
Formel: Durchschnittliche Zeit zum Testen einer Fehlerbehebung = Gesamtzeit zwischen Fehlerbehebung und erneutem Test für alle Fehler / Gesamtzahl der Fehler
Verteilung von Defekten
Die Fehlerverteilungsmetrik hilft Ihnen zu verstehen, welche Arten von Fehlern in Ihrem Produkt auftreten, wie sie mit dem Testen korrespondieren, welche Teile Ihrer Software (oder Ihres Prozesses) für Fehler anfällig sind und worauf Sie letztendlich Ihre Testanstrengungen konzentrieren sollten.
Teams, die diese QS-Kennzahl verfolgen, können Diagramme erstellen, die zeigen, wie sich die Verteilung der Fehler im Laufe der Zeit ändert, und Fehler auf der Grundlage von Variablen wie Ursache, Typ oder Schweregrad zuordnen. Durch die Analyse und den Vergleich dieser Zahlen können Teams ihre Fortschritte besser überwachen und die Qualität ihrer Veröffentlichungen verbessern. Die Metriken zur Fehlerverteilung umfassen die Anzahl, den Prozentsatz oder den Schweregrad von Fehlern, die nach Kategorien wie Schweregrad, Priorität, Testtyp usw. verteilt sind.
Fehlererkennung und -behebung
Die Metrik zur Fehlererkennung und -beseitigung gibt an, wie lange es dauert, Fehler in Ihrem Produkt zu finden und zu beseitigen. Für Tester ist es wichtig, zukünftige Testpläne zu planen und ihre Zeit und Prozesse effizienter zu gestalten. Die mittlere Zeit bis zur Entdeckung von Fehlern (MTTD) und die mittlere Zeit bis zur Behebung (MTTR) sind die beiden wichtigsten Metriken in dieser Kategorie:
Mittlere Zeit bis zur Entdeckung von Mängeln
Die mittlere Zeit bis zur Entdeckung von Fehlern oder MTTD bezieht sich auf die Zeit, die Ihr Unternehmen benötigt, um Probleme in einem Produkt zu entdecken. Je eher ein Fehler entdeckt wird, desto eher kann er behoben werden. Wir alle wissen, dass es viel einfacher (und billiger) ist, ein Problem früher zu beheben. Indem Sie messen, wie lange es dauert, Probleme zu entdecken, machen Sie den ersten Schritt zur Verbesserung dieser Zeit.
Sie können die MTTD ermitteln, indem Sie die für die Fehlersuche aufgewendete Zeit durch die Gesamtzahl der von Ihrem Team gefundenen Fehler dividieren.
Formel: MTTD = Zeitaufwand für das Auffinden von Fehlern / Gesamtzahl der gefundenen Fehler
Mittlere Zeit bis zur Lösung
Die mittlere Zeit bis zur Fehlerbehebung (MTTR) bezieht sich auf die Zeit, die ein Unternehmen durchschnittlich benötigt, um Fehler zu beheben, die sich auf die Benutzer auswirken. Die Verfolgung dieser Kennzahl ist wichtig, da eine niedrige MTTR entscheidend dafür ist, dass alle Systeme ordnungsgemäß funktionieren. Einfach ausgedrückt: Wenn etwas nicht funktioniert, sind die Benutzer verärgert und Sie verdienen weniger Geld.
Formel: MTTR = Zeitaufwand für die Behebung eines Fehlers / Gesamtzahl der gefundenen Fehler
ROI-Metriken testen
ROI-Metriken für das Testen helfen bei der Berechnung der Gesamtkosten für das Testen, der Gesamtkosten für einzelne Testkomponenten und des ROI für die Testprozesse Ihres Unternehmens. Es ist wichtig, die erwarteten Kosten für das Testen mit den tatsächlichen Ausgaben für das Testen zu vergleichen. Diese Kennzahlen können Entwicklern und QA-Leitern bei der Budgetierung künftiger Testausgaben und der Bewertung der Effizienz ihrer Testprozesse helfen. Sie können auch dabei helfen, den Arbeits- und Zeitaufwand zu ermitteln.
Kosten pro Fehlerbehebung
Die Kosten pro Fehlerbehebung sind eine testökonomische Kennzahl, die Ihnen Auskunft darüber gibt, wie viel es Ihr Unternehmen kostet, einen Fehler zu beheben. Die Kosten pro Fehlerbehebung errechnen sich aus dem Betrag, der pro Entwickler für einen Fehler ausgegeben wird.
Formel: Kosten pro Fehlerbehebung = Stundenaufwand für eine Fehlerbehebung x Stundensatz des Entwicklers
Beispiel: Wenn ein Entwickler 20 Stunden mit der Behebung eines Fehlers verbracht hat und sein Stundensatz 50 Dollar beträgt, dann betragen die Kosten für die Fehlerbehebung 20 * 50 Dollar = 1.000 Dollar. (Hinweis: Teams können auch die Kosten für erneute Tests berücksichtigen, um eine genauere Messung zu erhalten).
Kosten der Nichtprüfung
Diese Kennzahl hilft Ihnen, die Kosten zu verstehen, die entstehen, wenn Sie Ihr Produkt nicht testen. Wenn eine neue Reihe von Funktionen freigegeben wurde, aber überarbeitet werden musste, sind die Kosten für die Überarbeitung die "Kosten des Nichttestens". Dazu gehören nicht nur die Kosten, die mit der Überarbeitung eines Produkts verbunden sind, sondern auch subjektive Faktoren wie abnehmende Kundentreue, Gewinneinbußen, mehr Kundendienstanfragen und Produktausfälle.
Zeitplanabweichung
Die Terminabweichung ist die Differenz zwischen der geplanten Testzeit und der tatsächlichen Testzeit.
Formel:
Zeitplanabweichung (wenn die Tests früher als geplant beendet werden) = Geplanter Zeitplan - Tatsächlicher Zeitplan
Zeitplanabweichung (wenn die Tests später als geplant abgeschlossen werden) = tatsächlicher Zeitplan - geplanter Zeitplan
Glossar der Formeln für QA-Metriken
Kurzanleitung zur Berechnung gängiger QA-Kennzahlen:
- Testabdeckung = (Anforderungen mit Tests / Gesamtanforderungen) × 100
- Testausführungsabdeckung = (Durchgeführte Tests / Geplante Tests) × 100
- Fehlerinjektionsrate = Getestete Änderungen / Zurechenbare Probleme
- Fehlerdichte = Anzahl der Fehler / Release-Größe
- Fehlerleckage = (UAT-Fehler / Pre-UAT-Fehler) × 100
- Testfallwirksamkeit = (festgestellte Fehler / durchgeführte Testfälle) × 100
- Testdesign-Effizienz = Entworfene Tests / Entwurfszeit
- Fehlerfindungsrate = Gesamtzahl der Fehler / Gesamtzahl der Tests
- Durchschnittliche Zeit bis zur Fehlerbehebung = Gesamtzeit für erneute Tests / Gesamtzahl der Fehler
- MTTD = Zeit für die Lokalisierung von Fehlern / Lokalisierte Fehler
- MTTR = Zeit für die Behebung von Fehlern / Behebene Fehler
- Kosten pro Fehlerbehebung = Stunden × Stundensatz des Entwicklers
- Testfallproduktivität = Testfälle / Vorbereitungszeit
- Effizienz der Fehlerbehebung = Behebt Fehler / Gesamtzahl der Fehler zum Zeitpunkt der Messung
Wie man QA-Kennzahlen verfolgt und die Softwarequalität verbessert (Tools und Implementierung)
Das manuelle Nachverfolgen von Kennzahlen in Tabellenkalkulationen ist nicht skalierbar. Sie benötigen Tools, die Kennzahlen automatisch erfassen, berechnen und visualisieren.
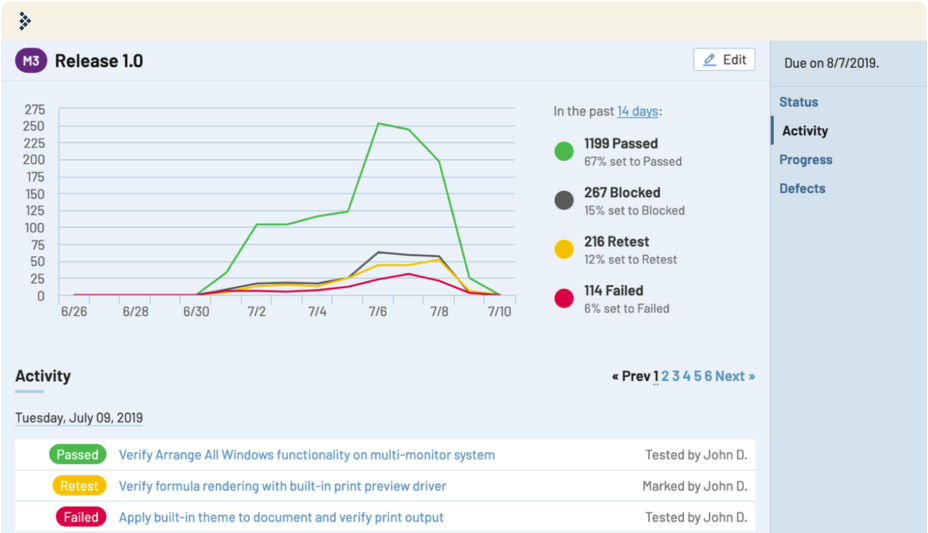
TestRail verfolgt QA-Kennzahlen während Ihres gesamten Testprozesses. Berichte bieten Einblick in den Projektstatus, Meilensteine und die Testdurchführung – und alles wird automatisch archiviert, sodass Sie Trends verfolgen und Releases vergleichen können.
Sind Sie bereit, intelligenter zu tracken? Effektive QA-Metrikprogramme:
- Fangen Sie klein an. Wählen Sie 3–5 Kennzahlen aus, die Ihre dringendsten Fragen beantworten. Fügen Sie weitere hinzu, sobald diese Kennzahlen funktionieren und Entscheidungen beeinflussen.
- Regelmäßig überprüfen. Passen Sie die Häufigkeit der Überprüfungen an die Häufigkeit der Entscheidungen an. Agile Teams überprüfen die Kennzahlen bei Sprint-Retrospektiven. Längere Release-Zyklen können monatlich überprüft werden.
- Handeln Sie auf der Grundlage von Daten. Metriken ohne Maßnahmen sind Zeitverschwendung. Wenn Metriken Probleme aufzeigen, untersuchen Sie die Ursachen und nehmen Sie Änderungen vor. Verfolgen Sie, ob diese Änderungen die Metrik verbessern.
- Teilen Sie Ihre Erkenntnisse mit anderen. Lassen Sie Metriken nicht nur in der Qualitätssicherung leben. Entwickler müssen Fehlermuster erkennen können. Produktmanager benötigen Daten zur Abdeckung. Führungskräfte benötigen ROI-Metriken. Transparenz schafft eine Kultur der Qualität.
- Vermeiden Sie Eitelkeitsmetriken. Verfolgen Sie Metriken, die Entscheidungen beeinflussen, nicht Metriken, die Sie gut aussehen lassen. „Durchgeführte Tests” lassen Sie beschäftigt aussehen. Die „Fehlerausfallrate” sagt Ihnen, ob das Testen funktioniert.
Verwendung von TestRail zur Messung von QA-Kennzahlen und zur Optimierung der Testabdeckung
TestRail verfolgt die wichtigen Kennzahlen:
- Dashboards anpassen, um sofortige Transparenz über Fortschritt, Abdeckung und Qualität zu erhalten
- Erhalten Sie erweiterte Anforderungen an die Rückverfolgbarkeit von Anforderungen, Testfällen und Fehlern
- Intuitive workflows schneller Navigation und Massenaktionen bereitstellen
- Erstellen Sie umfassende Berichte zur Testabdeckung, Ausführung und Fehler
- Integration mit Jira, GitHub, Azure DevOps, Jenkins, Selenium und mehr
Über 10.000 QA-Teams nutzen TestRail, um Software in höherer Qualität schneller auszuliefern. Starten Sie noch heute Ihre kostenlose 30-Tage-Testversion!.
Häufig gestellte Fragen zu QA-Testmetriken
Was ist der Unterschied zwischen QA-Kennzahlen und KPIs?
QA-Kennzahlen sind alle Messwerte, die sich auf Ihren Testprozess beziehen, und KPIs sind die spezifischen Kennzahlen, die Ihr Unternehmen verfolgt, weil sie für Ihre Geschäftsziele entscheidend sind. Alle KPIs sind Kennzahlen, aber nicht alle Kennzahlen sind KPIs. Wählen Sie Ihre KPIs danach aus, welche Entscheidungen sie beeinflussen.
Wie viele QA-Kennzahlen sollte ich verfolgen?
Die meisten Teams sind mit 5 bis 10 Kernkennzahlen erfolgreich. Bei weniger als 5 Kennzahlen entgehen Ihnen wichtige Signale. Bei mehr als 10 Kennzahlen verbringen Sie zu viel Zeit mit der Analyse von Daten, anstatt die Tests zu verbessern. Fangen Sie klein an und fügen Sie nur dann Kennzahlen hinzu, wenn diese Fragen beantworten, die Ihre aktuellen Kennzahlen nicht beantworten.
Sollte ich für manuelle und automatisierte Tests dieselben Kennzahlen verfolgen?
Nicht unbedingt. Manuelle und automatisierte Tests decken unterschiedliche Arten von Problemen auf. Manuelle Tests konzentrieren sich eher auf die Ausführungszeit und die Schwere der Fehler, während automatisierte Tests die Teststabilität, die Ausführungszeit und die Trends bei den Erfolgsraten in den Vordergrund stellen. Einige Kennzahlen, wie beispielsweise die Fehlererkennungsrate, gelten für beide.
Wie oft sollte ich die QA-Kennzahlen überprüfen?
Passen Sie die Häufigkeit Ihrer Überprüfungen an Ihren Entwicklungszyklus an. Agile Teams überprüfen Metriken in der Regel nach jedem Sprint. Teams mit längeren Release-Zyklen führen möglicherweise monatliche oder vierteljährliche Überprüfungen durch. Nutzen Sie Echtzeit-Dashboards für kontinuierliche Transparenz und führen Sie dann in regelmäßigen Abständen tiefergehende Analysen durch.
Was ist die wichtigste QA-Kennzahl, die es zu verfolgen gilt?
Die Antwort hängt davon ab, was Ihr größtes Qualitätsproblem ist. Für die meisten Teams ist die Fehlerquote (in der Produktion gefundene Fehler) am wichtigsten, da sie direkt misst, ob das Testen funktioniert. Wenn Ihr größtes Problem jedoch langsame Releases sind, konzentrieren Sie sich auf die Testdurchführungszeit. Wählen Sie Metriken, die Ihre wichtigsten Fragen beantworten.
In diesem Artikel:

Warum QA-Metriken wichtig sind:
Qualitätssicherungskennzahlen sind aus mehr als einem Grund wichtig. In erster Linie sind sie Entscheidungspunkte, die Sie zum Handeln veranlassen. Wie wirksam diese Maßnahmen zur Verbesserung Ihres Qualitätsniveaus sind, hängt von den von Ihnen gewählten Messgrößen ab.
QS-Metriken helfen Ihnen auch, Ihre Produktivität und Effizienz im Laufe der Zeit zu beurteilen. Wie viele Testfälle werden zu einer neuen Version hinzugefügt? Wie viele Tests werden beim ersten Durchlauf bestanden, wie viele erfordern einen erneuten Test, und wie viele führen zu neuen Fehlerberichten?
TestRail hilft Ihnen, diese QA-Metriken und vieles mehr im Auge zu behalten. Berichte auf verschiedenen Ebenen geben Ihnen Einblicke in den Projektstatus, Meilensteine oder sogar einzelne Testläufe. Alle Testergebnisse und Projektaktivitäten werden archiviert, so dass Sie aus der Vergangenheit lernen, Trends entdecken und mit jedem neuen Release-Zyklus besser vorbereitet sein können.
Schließen Sie sich mehr als 10.000 QA-Teams an, die TestRail nutzen, um fehlerfreie Produkte schneller auf den Markt zu bringen.





TestRail wird von führenden Unternehmen auf der ganzen Welt verwendet, um ihre Qualitätssicherungskennzahlen zu verfolgen.
Über das Produkt hinaus
Kostenloses Ebook: Der Leitfaden des QA-Leiters für agiles Testen
Dieser Leitfaden enthält umsetzbare und wirkungsvolle Tipps für das agile Testen, die Sie sofort einführen können, sowie ein "Crawl/Walk/Run"-Framework, das Ihrem Team hilft, an Bord zu kommen und erste Ergebnisse zu erzielen.

The First Edition Sembi Software Quality Pulse Report
This groundbreaking report compiles insights from nearly 4,000 software quality and security professionals to bring you the most honest, illuminating, and action-driven snapshot of the state of the industry yet. The findings include:
- The real-world impact of AI on software quality
- How teams are aligning quality and security
- The biggest 2026 priorities and challenges
- Und vieles mehr
Forrester TEI-Studie: 204% ROI mit TestRail
Lesen Sie die TestRail Total Economic Impact™ (TEI)-Studie, um zu erfahren, wie reale Kunden Softwaretests beschleunigen und gleichzeitig erhebliche Kosteneinsparungen erzielen, darunter:
- 204% ROI über drei Jahre
- 3,34 Millionen Dollar an Leistungen über drei Jahre
- 14-monatige Amortisationszeit
Laden Sie den vollständigen Bericht herunter, um mehr darüber zu erfahren, wie TestRail Ihrem Team helfen kann, Ergebnisse zu erzielen.